



Resposta curta: uma sincronização entre Salesforce e PostgreSQL de que a aplicação depende precisa de três coisas que um processo ETL não dá: alterações em segundos, escritas nos dois sentidos e uma regra para quando os dois lados editam o mesmo registo. Há três formas realistas de lá chegar: uma plataforma de sincronização gerida como a Stacksync, um pipeline próprio sobre o Salesforce Change Data Capture, ou o Heroku Connect para as equipas que já estão no Heroku Postgres. Para a maioria das empresas mid-market, a primeira é a mais indicada.
Sincronização operacional não é ETL
ETL e reverse ETL movem dados segundo um agendamento, quase sempre num único sentido, para alguém os analisar depois. É a ferramenta certa para um data warehouse. É a errada quando a aplicação lê a tabela do PostgreSQL no momento de cada pedido, ou quando um agente de suporte edita um registo no Salesforce e espera que a aplicação o reflita antes de o cliente voltar a ligar.
A sincronização operacional trata os dois sistemas como um único conjunto de dados mantido coerente. Isso muda os requisitos:
- A latência mede-se em segundos, não em janelas de processamento em lote.
- Os dois lados escrevem. O Salesforce é dono de uns campos, o PostgreSQL de outros, e alguns são editados em ambos.
- As falhas veem-se. Uma atualização perdida é um ecrã errado à frente de um cliente, não um dashboard ligeiramente desatualizado.
Se a necessidade é apenas analítica, um pipeline unidirecional para um data warehouse é mais simples e mais barato; o nosso guia sobre Salesforce para Snowflake em tempo real sem Heroku Connect cobre esse caminho. Esta página trata do caso operacional.
Três formas de sincronizar Salesforce e PostgreSQL
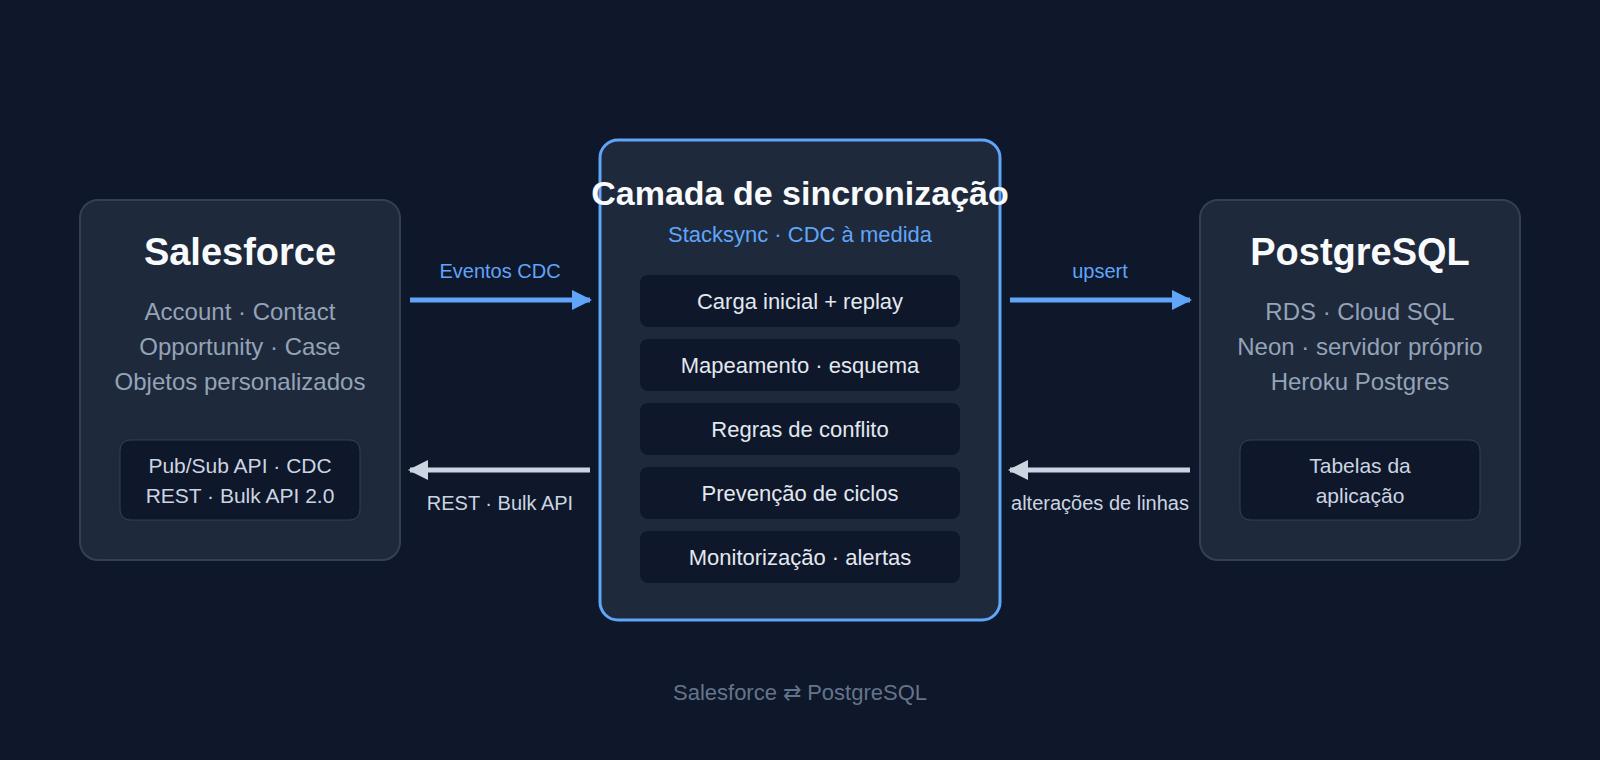
1. Uma plataforma gerida de sincronização bidirecional (Stacksync). A Stacksync liga o Salesforce ao PostgreSQL e a outras bases de dados com sincronização bidirecional em tempo real, com mapeamento de campos e monitorização incluídos. Não há infraestrutura de pipeline para operar. A Whalesync oferece uma sincronização bidirecional semelhante entre Salesforce e Postgres. É o caminho mais rápido para produção e o que recomendamos quando a sincronização é crítica mas não é o produto.
2. Um pipeline próprio sobre o Salesforce Change Data Capture. O Salesforce publica um evento de alteração sempre que um registo de um objeto subscrito é criado, atualizado, eliminado ou recuperado, entregue através da Pub/Sub API, baseada em gRPC. Os eventos ficam no event bus durante 72 horas e podem ser relidos a partir de um replay ID guardado. O CDC só flui para fora do Salesforce: a escrita de volta precisa de um caminho à parte, pela REST API ou pela Bulk API 2.0, e a carga inicial também requer a Bulk API 2.0. Este caminho dá controlo total e custa um pipeline para construir, operar e manter em piquete.
3. Heroku Connect (legado). O Heroku Connect sincroniza o Salesforce com uma base de dados Heroku Postgres, apenas em leitura ou em leitura e escrita. Lê por polling, com um modo opcional de polling acelerado que escuta através da Streaming API ou do CDC, e escreve de volta fazendo polling de uma tabela de registo de triggers no Postgres. Só trabalha com o Heroku Postgres e, desde fevereiro de 2026, o Heroku funciona num modelo de «sustaining engineering», centrado na estabilidade e não em funcionalidades novas.
O que uma sincronização bidirecional tem de resolver bem
A sincronização bidirecional falha em sítios previsíveis. Qualquer que seja a opção escolhida, estas são as peças que desenhamos e testamos antes do go-live:
- Propriedade por campo. Definir que sistema é a fonte de verdade de cada campo e que campos são realmente editados nos dois lados. A maioria dos conflitos desaparece assim que isto fica escrito.
- Resolução de conflitos. Quando os dois lados alteram o mesmo registo, decide uma regra: ganha a última escrita, ganha sempre um sistema, ou uma regra por campo. Tem de ser explícita, não um acaso de tempos.
- Prevenção de ciclos. Uma alteração escrita no PostgreSQL não pode voltar ao Salesforce como alteração nova, nem o contrário. Escritas idempotentes e o registo da origem de cada alteração cortam o eco.
- Carga inicial e entrada em funcionamento. A primeira cópia dos dados chega em massa; o fluxo em direto tem de começar num ponto que se sobreponha a ela, ou surgem duplicados ou falhas.
- Eliminações e fusões. Registos do Salesforce eliminados, recuperados ou fundidos precisam de uma regra explícita no PostgreSQL, ou a base de dados vai-se enchendo de fantasmas.
- Alterações de esquema. Os administradores acrescentam campos. A sincronização tem de detetar um campo novo no Salesforce e mapeá-lo ou alertar, em vez de o descartar em silêncio.
- Limites de API. O Salesforce limita as chamadas à API e a entrega de eventos por org. Uma sincronização que os ignore acaba por estrangular as outras integrações.
- Recuperação. Se o consumidor estiver em baixo mais do que as 72 horas da janela de replay do CDC, só uma reconciliação completa contra um snapshot em massa repõe a coerência. Deve ser planeada antes de ser precisa.
Tabela comparativa
| Stacksync (gerido) | Pipeline de CDC próprio | Heroku Connect | |
|---|---|---|---|
| Direção | Bidirecional | Salesforce → Postgres com CDC; escrita de volta construída à parte | Apenas leitura ou leitura e escrita |
| Como se detetam as alterações | Motor de sincronização em tempo real, gerido | Eventos CDC pela Pub/Sub API | Polling, com polling acelerado opcional |
| Destinos PostgreSQL | Qualquer PostgreSQL operado pela empresa | Qualquer PostgreSQL operado pela empresa | Apenas Heroku Postgres |
| Carga inicial | Incluída | Construída internamente (Bulk API 2.0) | Incluída |
| Regras de conflito, prevenção de ciclos | Configuradas | Construídas internamente | Integradas, com pouco controlo |
| O que fica a operar | Configuração e monitorização | Todo o pipeline | O add-on do Heroku |
| Melhor encaixe | Sincronização crítica, equipa de plataforma pequena | A sincronização é propriedade intelectual central, equipa de dados forte | Aplicações já no Heroku, sem migração prevista para já |
Comece pela última linha. Se a sincronização é um meio, compre-a. Se faz parte do que a empresa vende, ou se os volumes e as regras de conformidade tornam uma plataforma incómoda, construa-a. A nossa análise build vs buy para substituir o Heroku Connect aprofunda esse equilíbrio, e Salesforce CDC vs Heroku Connect explica o que o CDC cobre e o que não cobre.
Sair do Heroku Connect
O Heroku Connect continua a funcionar, e nada do que foi anunciado até agora fixa uma data de fim. O que mudou foi a direção: o Heroku está em modo de sustaining engineering, e o Heroku Connect só sincroniza com o Heroku Postgres. As equipas que mudam a base de dados para Amazon RDS, Cloud SQL, Neon ou servidores próprios perdem o Heroku Connect pelo caminho.
Uma migração a partir do Heroku Connect tem uma forma conhecida: inventariar cada mapeamento, reconstruir cada fluxo na nova sincronização em modo sombra só de leitura, comparar contagens de linhas e valores, passar as escritas objeto a objeto e, por fim, remover o add-on. O nosso guia de migração do Heroku Connect em fim de vida percorre-a passo a passo.
O que implementamos
- Arquitetura de sincronização: que objetos, em que direção, que sistema é dono de cada campo e as regras de conflito, por escrito antes de se configurar o que quer que seja.
- Implementação da Stacksync, como parceiro oficial da Stacksync: ligações, mapeamento de campos, conversão de tipos, filtros e alertas, testados primeiro contra uma sandbox do Salesforce.
- Pipelines de CDC à medida quando uma plataforma não encaixa: consumidores da Pub/Sub API, carga retroativa com a Bulk API 2.0, escrita de volta idempotente, tarefas de replay e de reconciliação.
- Migrações a partir do Heroku Connect, com execução em paralelo e um plano de passagem por objeto.
- Suporte em produção: monitorização, alterações de esquema à medida que a org do Salesforce evolui, e um engenheiro designado que conhece a configuração.
Como decorre um projeto
- Descoberta. Analisamos os objetos do Salesforce, o esquema do PostgreSQL e os fluxos de que a aplicação precisa, e recomendamos a Stacksync ou um desenvolvimento à medida, com os motivos.
- Desenho. Propriedade dos campos, direção, regras de conflito, tratamento de eliminações e alertas, acordados com a sua equipa.
- Construção em sandbox. Carga inicial completa e sincronização em direto contra uma sandbox do Salesforce e uma cópia da base de dados.
- Execução em paralelo. A nova sincronização corre ao lado da solução atual até os dados coincidirem.
- Go-live e passagem de testemunho. Passagem objeto a objeto, runbook e monitorização em funcionamento, suporte após o arranque.
Fontes
- Heroku Dev Center, Heroku Connect (destino Heroku Postgres, planos e limites). Consultado a 29 de setembro de 2026.
- Heroku Dev Center, Reading Data from Salesforce with Heroku Connect (polling, polling acelerado). Consultado a 29 de setembro de 2026.
- Heroku Dev Center, Writing Data to Salesforce with Heroku Connect (registo de triggers, algoritmos de escrita). Consultado a 29 de setembro de 2026.
- Salesforce Developers, Change Data Capture Developer Guide. Consultado a 29 de setembro de 2026.
- Salesforce Developers, Pub/Sub API: Event Message Durability (retenção de 72 horas, replay ID). Consultado a 29 de setembro de 2026.
- Salesforce Developers, Bulk API 2.0. Consultado a 29 de setembro de 2026.
- The Register, Heroku freeze, 9 de fevereiro de 2026 (modelo de sustaining engineering). Consultado a 29 de setembro de 2026.
- Stacksync, PostgreSQL and Salesforce integration. Consultado a 29 de setembro de 2026.
- Whalesync, Salesforce and Postgres two-way sync. Consultado a 29 de setembro de 2026.