



Respuesta corta: una sincronización entre Salesforce y PostgreSQL de la que depende su aplicación necesita tres cosas que un proceso ETL no ofrece: cambios en segundos, escrituras en ambas direcciones y una regla para cuando los dos lados editan el mismo registro. Hay tres formas realistas de conseguirlo: una plataforma de sincronización gestionada como Stacksync, un pipeline propio sobre Salesforce Change Data Capture, o Heroku Connect para los equipos que ya están en Heroku Postgres. A la mayoría de las empresas mid-market les conviene la primera.
La sincronización operativa no es ETL
ETL y reverse ETL mueven datos según una programación, casi siempre en una sola dirección, para que alguien los analice después. Es la herramienta adecuada para un data warehouse. Es la equivocada cuando su aplicación lee la tabla de PostgreSQL en el momento de cada petición, o cuando un agente de soporte edita un registro en Salesforce y espera que la aplicación lo refleje antes de que el cliente vuelva a llamar.
La sincronización operativa trata los dos sistemas como un único conjunto de datos que se mantiene coherente. Eso cambia los requisitos:
- La latencia se mide en segundos, no en ventanas de proceso por lotes.
- Los dos lados escriben. Salesforce es dueño de unos campos, PostgreSQL de otros, y algunos se editan en ambos.
- Los fallos se ven. Una actualización perdida es una pantalla incorrecta delante de un cliente, no un dashboard algo desfasado.
Si solo necesita analítica, un pipeline unidireccional hacia un data warehouse es más sencillo y más barato; nuestra guía sobre Salesforce a Snowflake en tiempo real sin Heroku Connect cubre ese camino. Esta página trata el caso operativo.
Tres formas de sincronizar Salesforce y PostgreSQL
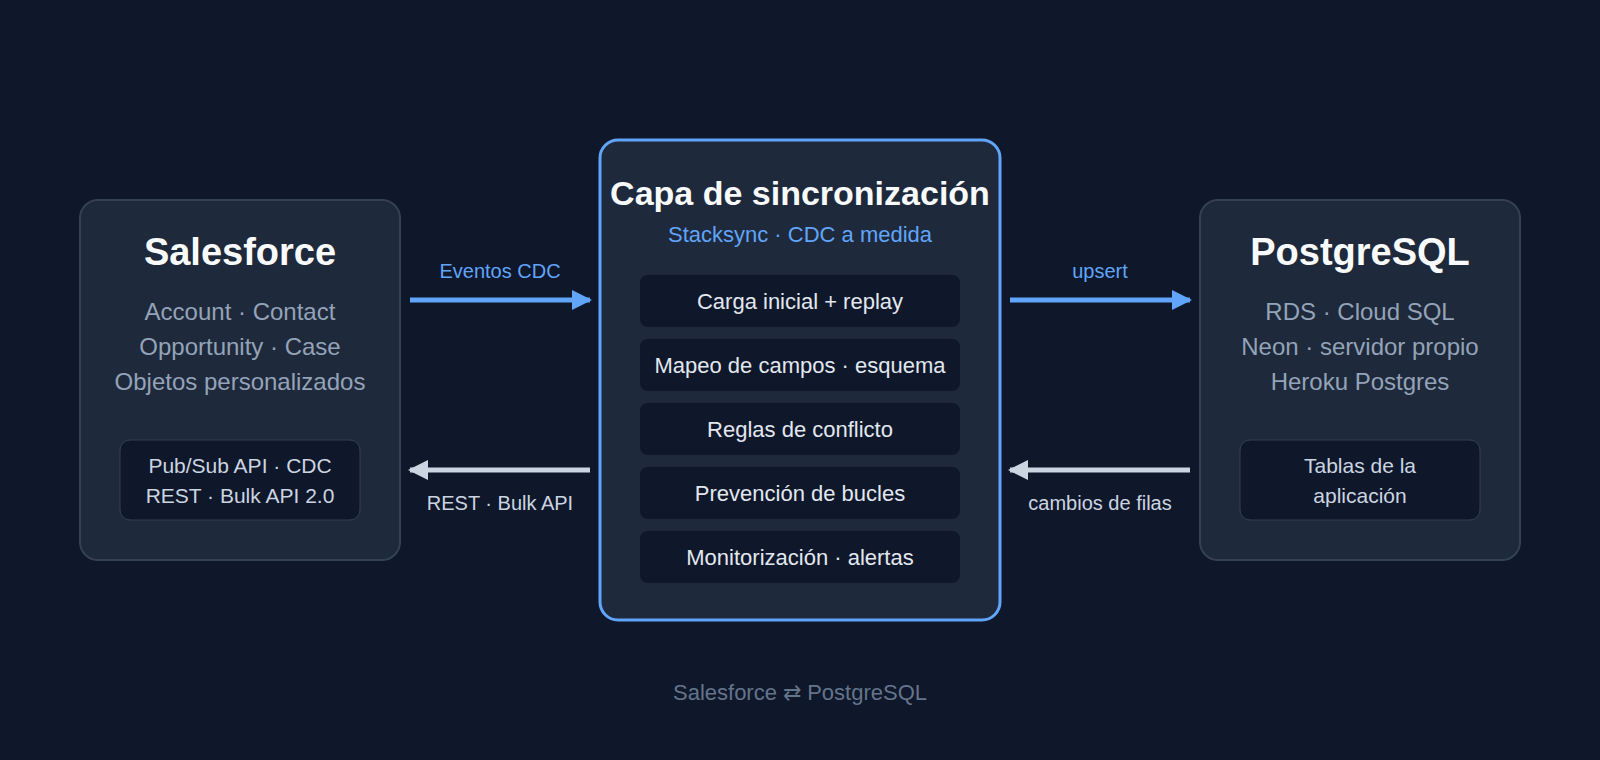
1. Una plataforma gestionada de sincronización bidireccional (Stacksync). Stacksync conecta Salesforce con PostgreSQL y otras bases de datos mediante sincronización bidireccional en tiempo real, con mapeo de campos y monitorización incluidos. Usted no opera ninguna infraestructura de pipeline. Whalesync ofrece una sincronización bidireccional similar entre Salesforce y Postgres. Es la vía más rápida a producción y la que recomendamos cuando la sincronización es crítica pero no es su producto.
2. Un pipeline propio sobre Salesforce Change Data Capture. Salesforce publica un evento de cambio cada vez que un registro de un objeto suscrito se crea, se actualiza, se elimina o se recupera, y lo entrega a través de la Pub/Sub API, basada en gRPC. Los eventos permanecen en el bus de eventos 72 horas y pueden volver a leerse desde un replay ID guardado. CDC solo fluye hacia fuera de Salesforce: la escritura de vuelta necesita un camino aparte a través de la REST API o la Bulk API 2.0, y la carga inicial también requiere la Bulk API 2.0. Este camino le da el control total y le cuesta un pipeline que construir, operar y vigilar con guardias.
3. Heroku Connect (heredado). Heroku Connect sincroniza Salesforce con una base de datos Heroku Postgres, en solo lectura o en lectura y escritura. Lee mediante sondeo (polling), con un modo opcional de sondeo acelerado que escucha a través de la Streaming API o de CDC, y escribe de vuelta sondeando una tabla de registro de triggers en Postgres. Solo trabaja con Heroku Postgres y, desde febrero de 2026, Heroku funciona bajo un modelo de «sustaining engineering», centrado en la estabilidad y no en funcionalidades nuevas.
Lo que una sincronización bidireccional tiene que resolver bien
La sincronización bidireccional falla en sitios previsibles. Elija la opción que elija, estas son las piezas que diseñamos y probamos antes del go-live:
- Propiedad por campo. Decida qué sistema es la fuente de verdad de cada campo y qué campos se editan realmente en ambos lados. La mayoría de los conflictos desaparecen en cuanto esto queda por escrito.
- Resolución de conflictos. Cuando los dos lados cambian el mismo registro, decide una regla: gana la última escritura, gana siempre un sistema, o una regla por campo. Tiene que ser explícita, no un accidente de sincronización temporal.
- Prevención de bucles. Un cambio escrito en PostgreSQL no debe volver a Salesforce como un cambio nuevo, ni al revés. Las escrituras idempotentes y el registro del origen de cada cambio cortan el eco.
- Carga inicial y enganche. La primera copia de los datos llega en bloque; el flujo en vivo tiene que empezar en un punto que se solape con ella, o tendrá duplicados o huecos.
- Eliminaciones y fusiones. Los registros de Salesforce eliminados, recuperados o fusionados necesitan una regla explícita en PostgreSQL, o la base de datos se va llenando de fantasmas.
- Cambios de esquema. Los administradores añaden campos. La sincronización tiene que detectar un campo nuevo en Salesforce y mapearlo o avisar, en lugar de descartarlo en silencio.
- Límites de API. Salesforce limita las llamadas a la API y la entrega de eventos por org. Una sincronización que los ignore acabará estrangulando sus otras integraciones.
- Recuperación. Si el consumidor está caído más de las 72 horas de la ventana de replay de CDC, solo una reconciliación completa contra una instantánea masiva restablece la coherencia. Planifíquela antes de necesitarla.
Tabla comparativa
| Stacksync (gestionado) | Pipeline de CDC propio | Heroku Connect | |
|---|---|---|---|
| Dirección | Bidireccional | Salesforce → Postgres con CDC; escritura de vuelta construida aparte | Solo lectura o lectura y escritura |
| Cómo se detectan los cambios | Motor de sincronización en tiempo real, gestionado | Eventos CDC por la Pub/Sub API | Sondeo, con sondeo acelerado opcional |
| Destinos PostgreSQL | Cualquier PostgreSQL que usted opere | Cualquier PostgreSQL que usted opere | Solo Heroku Postgres |
| Carga inicial | Incluida | La construye usted (Bulk API 2.0) | Incluida |
| Reglas de conflicto, prevención de bucles | Se configuran | Las construye usted | Integradas, con poco control |
| Qué opera usted | Configuración y monitorización | Todo el pipeline | El add-on de Heroku |
| Encaja mejor | Sincronización crítica, equipo de plataforma pequeño | La sincronización es propiedad intelectual clave, equipo de datos sólido | Aplicaciones que ya están en Heroku, sin migración prevista todavía |
Lea primero la última fila. Si la sincronización es un medio, cómprela. Si forma parte de lo que usted vende, o sus volúmenes y sus normas de cumplimiento hacen incómoda una plataforma, constrúyala. Nuestro análisis build vs buy para sustituir Heroku Connect profundiza en ese equilibrio, y Salesforce CDC frente a Heroku Connect explica qué cubre CDC y qué no.
Salir de Heroku Connect
Heroku Connect sigue funcionando, y nada de lo anunciado hasta ahora fija una fecha de fin. Lo que ha cambiado es la dirección: Heroku está en modo de sustaining engineering, y Heroku Connect solo sincroniza con Heroku Postgres. Los equipos que trasladan su base de datos a Amazon RDS, Cloud SQL, Neon o a sus propios servidores pierden Heroku Connect por el camino.
Una migración desde Heroku Connect tiene una forma conocida: inventariar cada mapeo, reconstruir cada flujo en la nueva sincronización en modo sombra de solo lectura, comparar recuentos de filas y valores, pasar las escrituras objeto a objeto y, por último, retirar el add-on. Nuestra guía de migración por el fin de vida de Heroku Connect la recorre paso a paso.
Qué implementamos
- Arquitectura de sincronización: qué objetos, en qué dirección, qué sistema es dueño de cada campo y las reglas de conflicto, por escrito antes de configurar nada.
- Implantación de Stacksync, como partner oficial de Stacksync: conexiones, mapeo de campos, conversión de tipos, filtros y alertas, probados primero contra un sandbox de Salesforce.
- Pipelines de CDC a medida cuando una plataforma no encaja: consumidores de la Pub/Sub API, carga retroactiva con la Bulk API 2.0, escritura de vuelta idempotente, trabajos de replay y de reconciliación.
- Migraciones desde Heroku Connect, con ejecución en paralelo y un plan de corte por objeto.
- Soporte en producción: monitorización, cambios de esquema a medida que evoluciona su org de Salesforce y un ingeniero asignado que conoce su configuración.
Cómo se desarrolla un proyecto
- Descubrimiento. Revisamos sus objetos de Salesforce, su esquema de PostgreSQL y los flujos que necesita su aplicación, y le recomendamos Stacksync o un desarrollo a medida, con los motivos.
- Diseño. Propiedad de los campos, dirección, reglas de conflicto, tratamiento de eliminaciones y alertas, acordados con su equipo.
- Construcción en sandbox. Carga inicial completa y sincronización en vivo contra un sandbox de Salesforce y una copia de su base de datos.
- Ejecución en paralelo. La nueva sincronización funciona junto a lo que utiliza hoy hasta que los datos coinciden.
- Go-live y traspaso. Corte objeto a objeto, runbook y monitorización en marcha, soporte después del lanzamiento.
Fuentes
- Heroku Dev Center, Heroku Connect (destino Heroku Postgres, planes y límites). Consultado el 29 de septiembre de 2026.
- Heroku Dev Center, Reading Data from Salesforce with Heroku Connect (sondeo, sondeo acelerado). Consultado el 29 de septiembre de 2026.
- Heroku Dev Center, Writing Data to Salesforce with Heroku Connect (registro de triggers, algoritmos de escritura). Consultado el 29 de septiembre de 2026.
- Salesforce Developers, Change Data Capture Developer Guide. Consultado el 29 de septiembre de 2026.
- Salesforce Developers, Pub/Sub API: Event Message Durability (retención de 72 horas, replay ID). Consultado el 29 de septiembre de 2026.
- Salesforce Developers, Bulk API 2.0. Consultado el 29 de septiembre de 2026.
- The Register, Heroku freeze, 9 de febrero de 2026 (modelo de sustaining engineering). Consultado el 29 de septiembre de 2026.
- Stacksync, PostgreSQL and Salesforce integration. Consultado el 29 de septiembre de 2026.
- Whalesync, Salesforce and Postgres two-way sync. Consultado el 29 de septiembre de 2026.